Chaotic Pendulum Lab · 从企业中生长的 Neo Lab
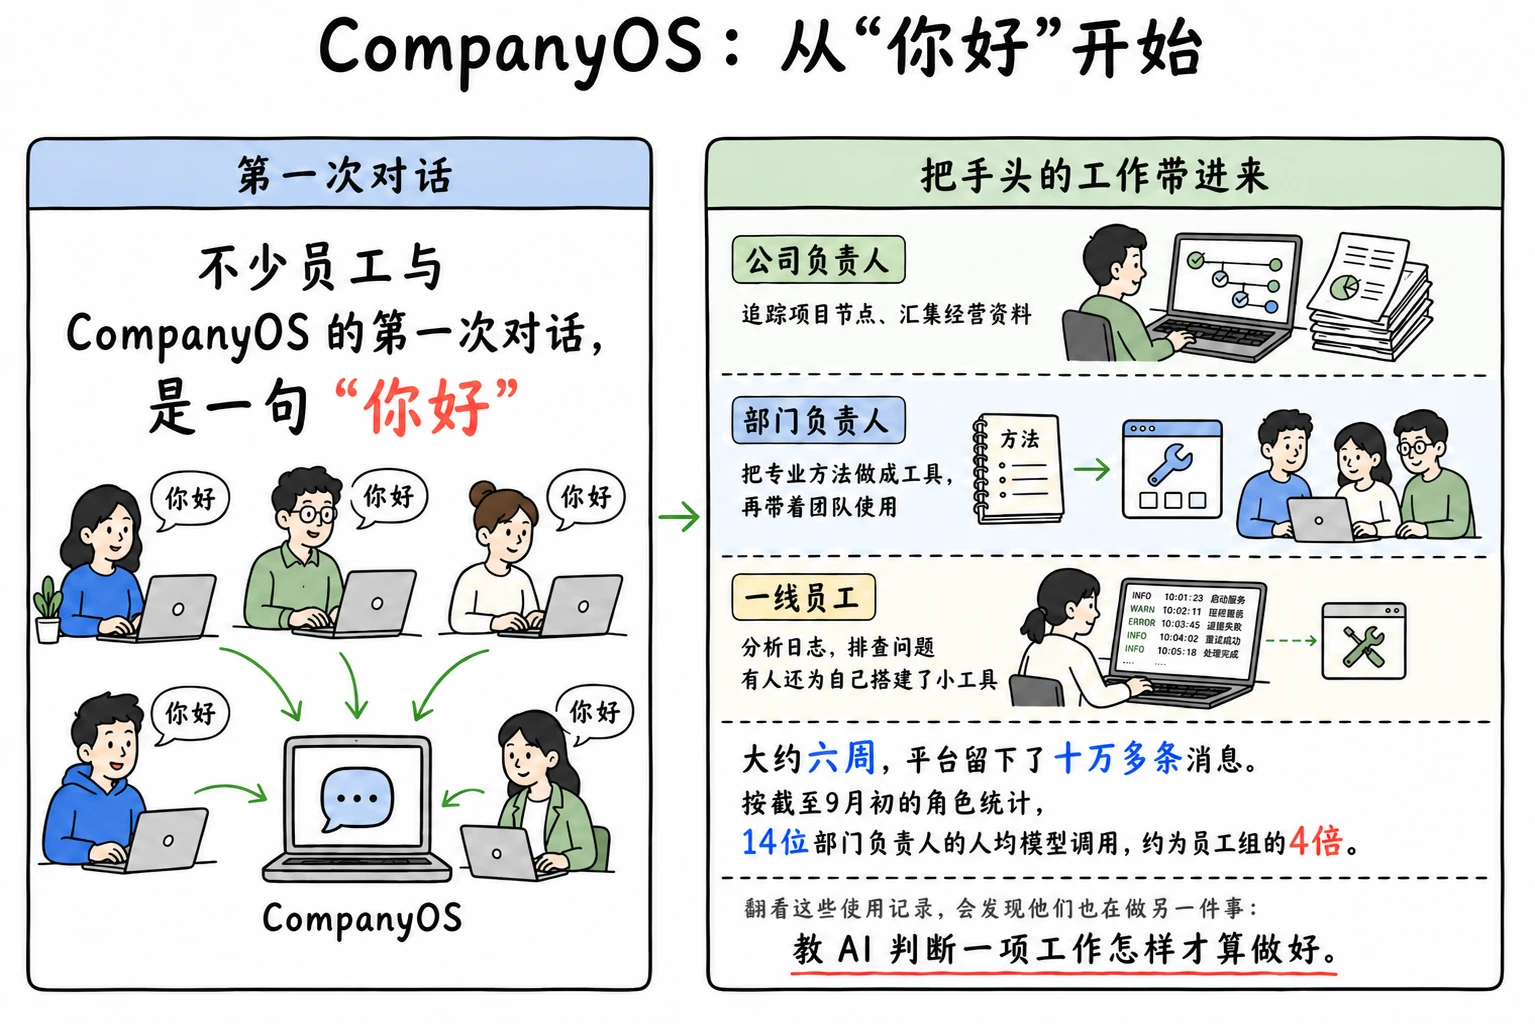
一家刚完成数亿元B+轮融资的硬科技企业,在使用 CompanyOS 的约六周里,与 Agent 的对话已超过十万轮。
公司负责人亲自搭建经营助手,工程师把专业方法做成内部应用。在一次实跑演示中,Agent 组合调用这些应用,参与整机方案设计。
一次 PCB 复检中,工程师纠正过的检查规则被保存下来。第二天新开对话复检时,同一智能体沿用了这些规则,没有再犯那几类错误。
这家企业已经开始把自己的专业判断用来改进 AI 的工作方法。企业的下一次进步,不该只等模型公司的下一次发布。
混沌摆是一家研究递归自我改进(RSI)的 Neo Lab。我们先在量化领域研究 AI 怎样从结果中学习,再把这套方法带进企业的日常工作。
01 把回测带进企业
量化方法会随市场变化而失效。一个过去有效的因子,后来可能不再有效。研究者需要通过回测发现问题,再检验新的方法。
团队沿着因子衰减这一问题开展了 AlphaAgent 系列研究,并在 AlphaAgentEvo(ICLR 2026)中探索用强化学习,把回测反馈用于改进模型。系统尝试一种方法,得到结果,再根据反馈调整后续探索。
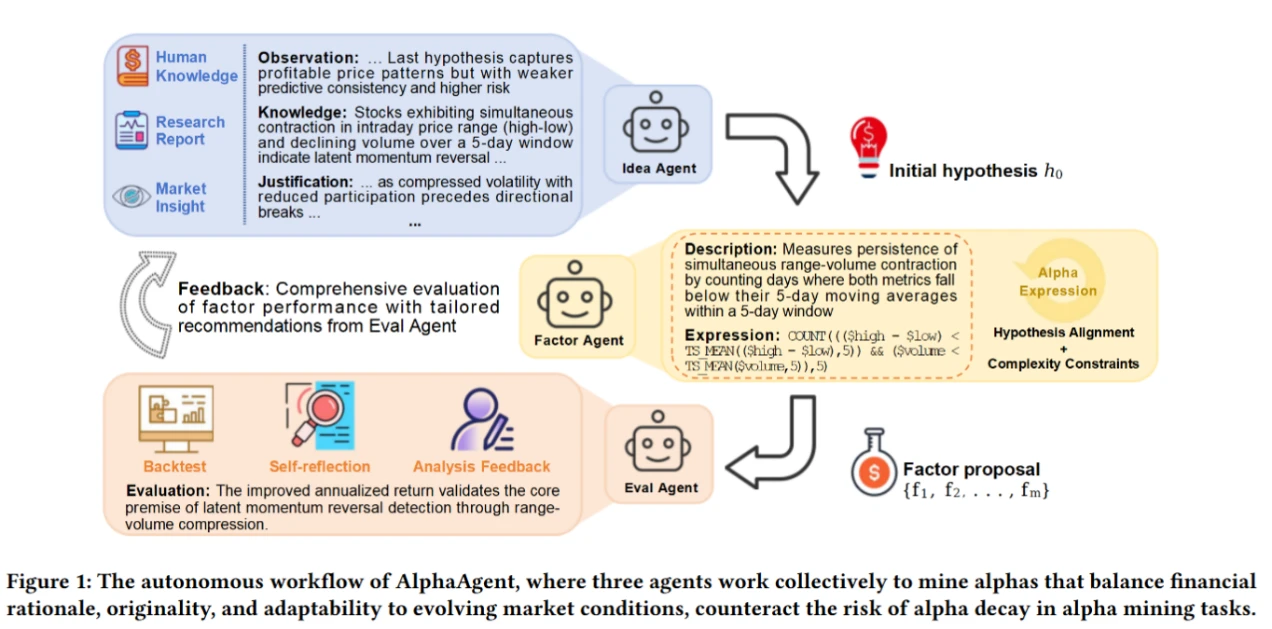
图片来源 AlphaAgent 论文
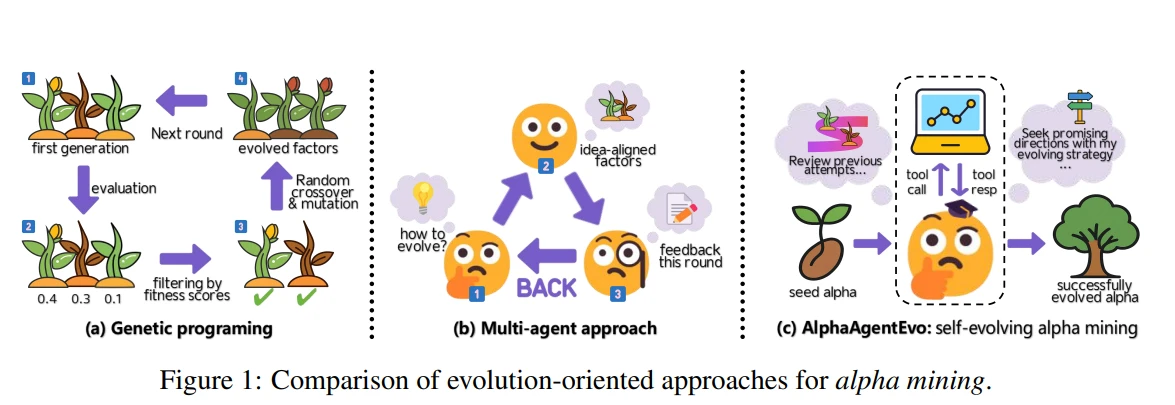
图片来源 AlphaAgentEvo 论文
我们希望把这种学习方式带到更多工作中。为此,团队从金融研究中整理出自进化学习框架,再与愿意深度合作的企业一起,在金融和制造两类场景中验证。
我们想把“回测”带进企业,让新旧方法接受同一套业务标准的检验。
这也带来了新的难题。金融有相对清晰的回测信号,企业里的一份报告能不能交、一次检查有没有遗漏,往往需要资深员工判断。要让 AI 从这些反馈中学习,就要先弄清楚专家为什么这样判断。
02 制造企业给了我们怎样的研究问题
在制造企业,一项任务常常要跨过多个系统。设计资料、器件手册和检查要求来自不同地方,工程师需要对照它们,才能判断一个连接是否正确。完成整机方案设计,还需要调用不同的专业工具。
这样的工作,让我们能研究 AI 在复杂条件下怎样学习。开篇的 PCB 案例中,工程师指出了错误,也讲清了判断依据,系统才有了可以用于下一次复检的规则。我们尤其关注小样本持续学习,希望少量高质量的纠正,能够帮助更多相似任务,而不必每次都从头教起。
这套研究框架覆盖数据、记忆、框架和模型四个层面。任务记录用于寻找问题和构建评测,确认过的经验可以写入记忆与技能。执行流程和工具编排也可以调整;模型的专项能力,则可以通过后训练改进。评测帮助我们比较不同改法的效果。
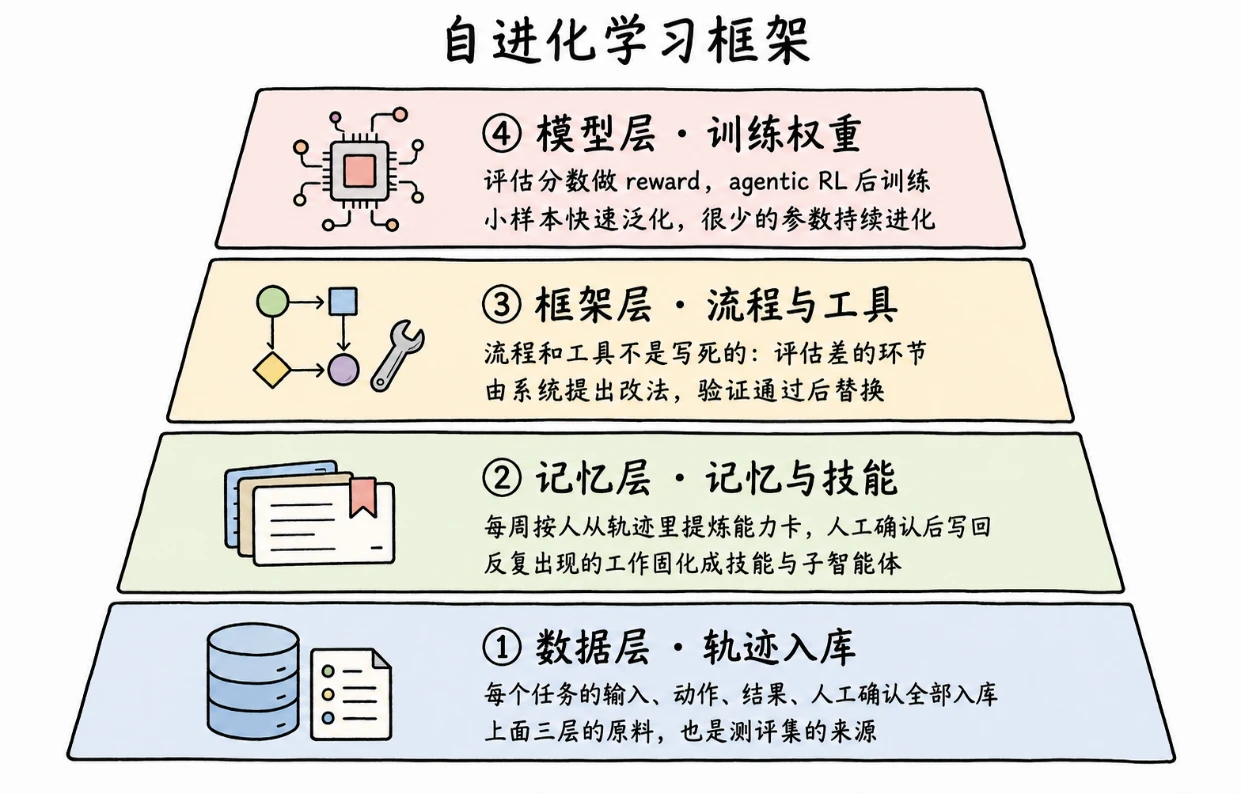
研究路线示意,当前进展见下文。
这些改进需要长期跟踪。系统在原任务上少犯了一次错,换到相似任务后是否仍然有效?业务条件变化时,之前的经验又该怎样更新?
与企业持续合作,让我们能在客户授权范围内接触实际任务和专家反馈,并回到后续工作中检验方法。我们选择制造企业,是为了在复杂的真实工作中,研究并验证 AI 怎样从经验中持续改进。
目前,金融线已有强化学习后训练研究;企业线已有跨对话规则复用,以及记忆、技能和专业应用的积累。企业任务评测仍在建设,我们将用它检验更多任务上的效果,并推进相应后训练。
03 构建一个 AI 自运行组织
我们的长期目标,是构建一个 AI 自运行组织。
我们希望 CompanyOS 能承接企业的目标,组织智能体分工协作。一项工作开始后,系统能够拆解任务,找到所需的资料和工具,再把各个环节的结果接起来,持续推进。遇到超出权限或无法判断的问题,交给人处理。
系统还要从工作结果和人的纠正中学习,改进下一次执行。
再往前一步,AI 还要改进自己寻找问题、验证方法的能力。这是我们持续推进 RSI 研究的方向。今天已经发生的规则复用和工具协作,是走向这个目标的起点。
人确定目标和授权范围,关键决策仍由人把关。
我们要让 AI 接管自己的进化。
Chaotic Pendulum Lab 混沌摆科技
让智能产生复利。